
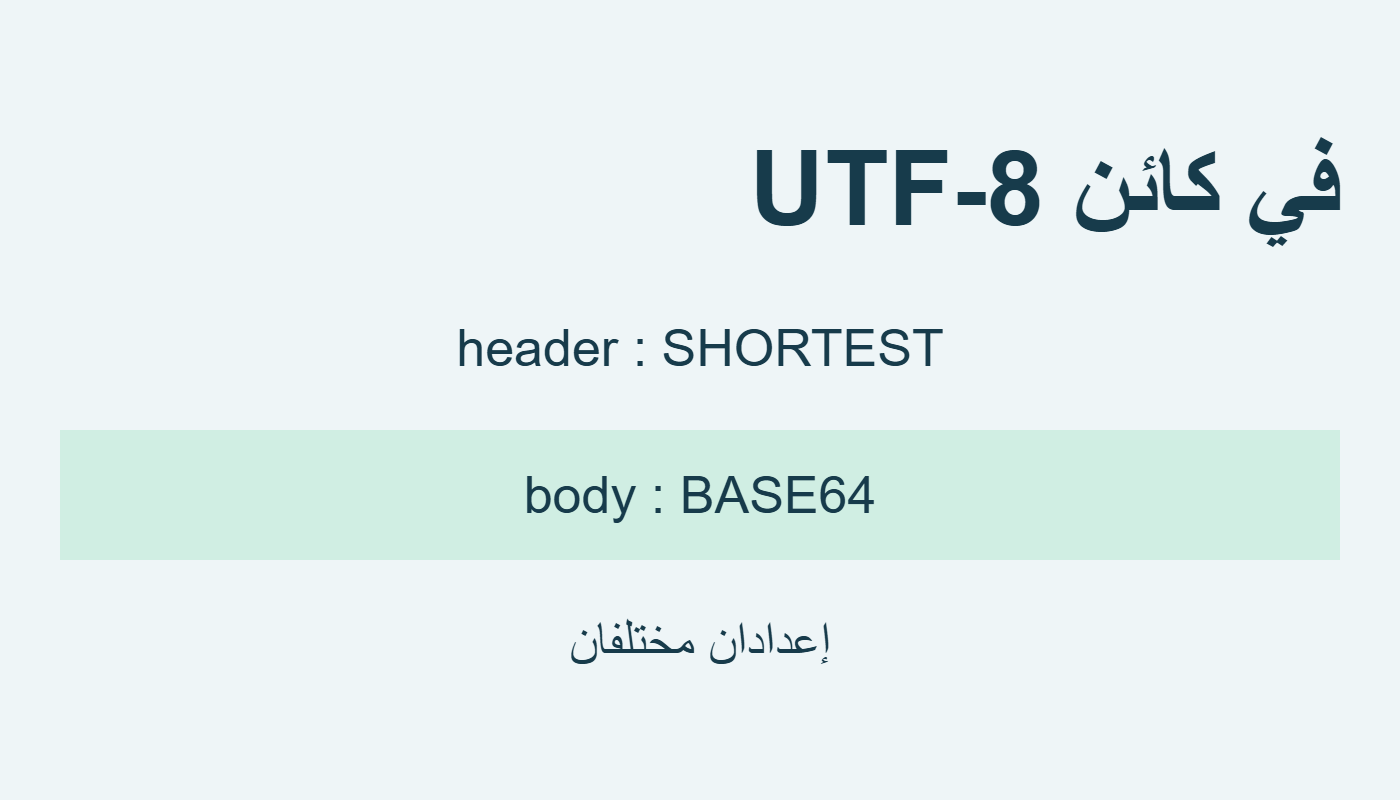
نقرأ إعدادًا من واجهة البريد القديمة Compat32. [1] [2]
الخلاصة السريعة
المثال
from email.charset import Charset,SHORTEST,BASE64
c=Charset('utf-8')
print(c.header_encoding==SHORTEST,c.body_encoding==BASE64)
print(c.get_body_encoding())إعداد الرأس وإعداد الجسم
الإعداد هنا صفة للكائن. SHORTEST يعني اختيار الأقصر بين quoted-printable وbase64 للرأس؛ لا يجوز استعماله إعدادًا للجسم. قراءة اسم ترميز الجسم ليست نص الجسم المرمز. [1] [2]
تغيير واحد وحدود الفحص
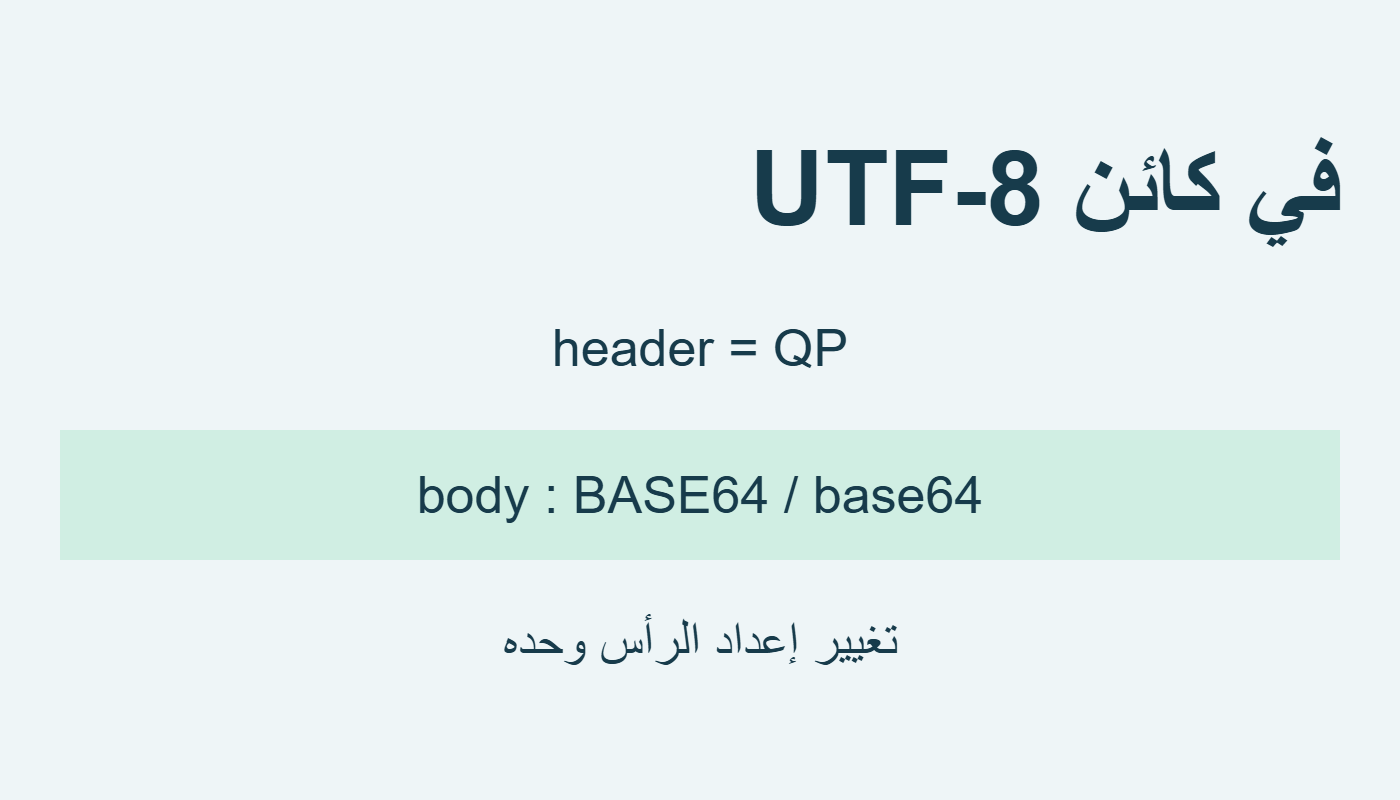
في كائن جديد، نضع c.header_encoding=QP بعد استيراد الثابت. يبقى c.body_encoding==BASE64 صحيحًا، ويبقى الاسم base64. أما تغيير إعداد الجسم إلى QP فيعيد quoted-printable. لم نغير السجل العام أو نختبر طي الرؤوس أو وصول بريد. [1] [2]
المراجع
- Python: email.charset
- CPython3.12.14: charset.py
- موضوع تك: لغة بايثون — مفردات
- موضوع تك: تطبيقات بايثون — مفردات
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.