
قارن النص الناتج، لا مظهر الحرف وحده. [1] [2]
الخلاصة السريعة
المثال
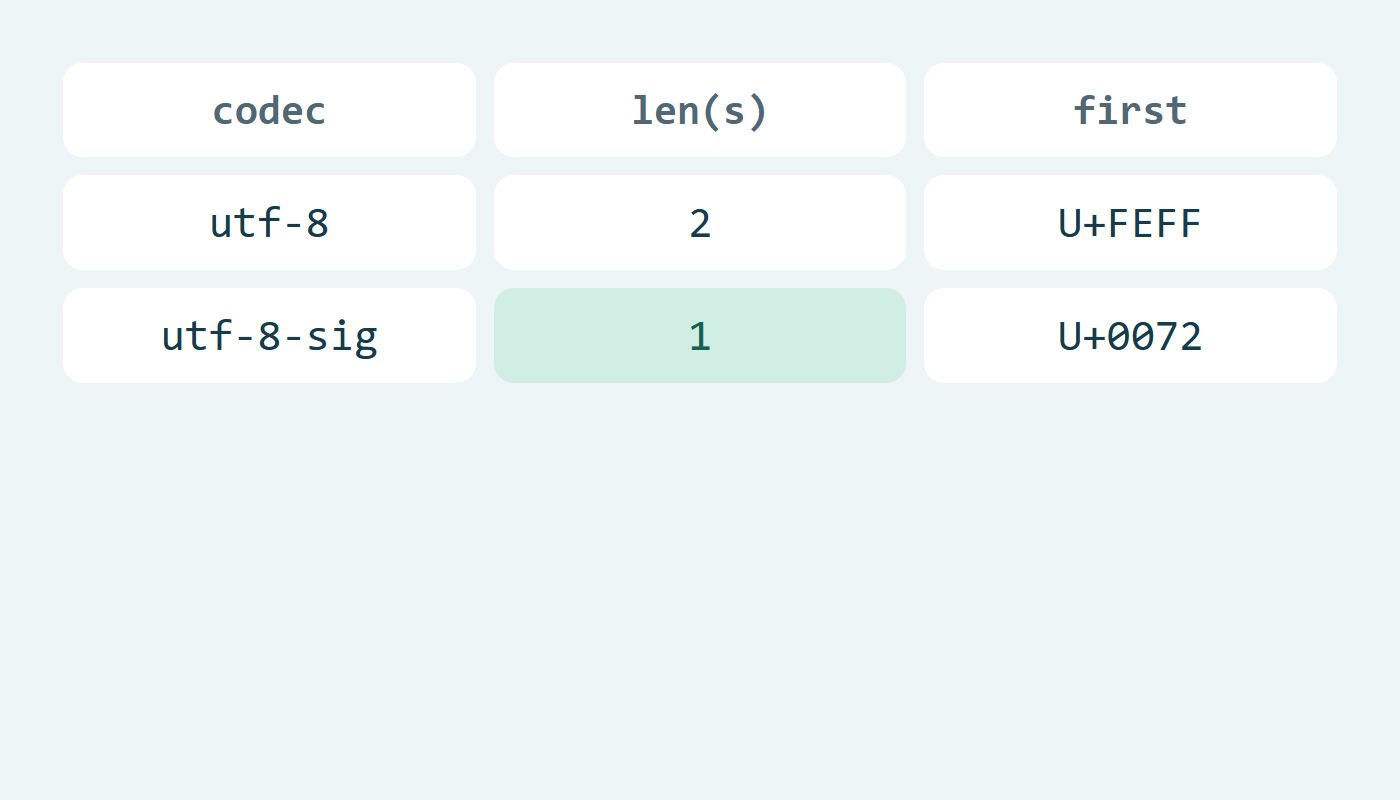
b=bytes.fromhex('efbbbf72')
for c in ('utf-8','utf-8-sig'):
 s=b.decode(c)
print(len(s),ord(s[0]))المخرجات: 2 65279 ثم 1 114. [1] [2]
الأعداد نقاط يونيكود: 65279=U+FEFF و114=U+0072، أي r. الطول يعد المحارف، لا البايتات. [1] [2]
موضع التوقيع
داخل البايتات 72 EF BB BF، يعطي الخياران محرفين: r ثم U+FEFF. [1] [2]
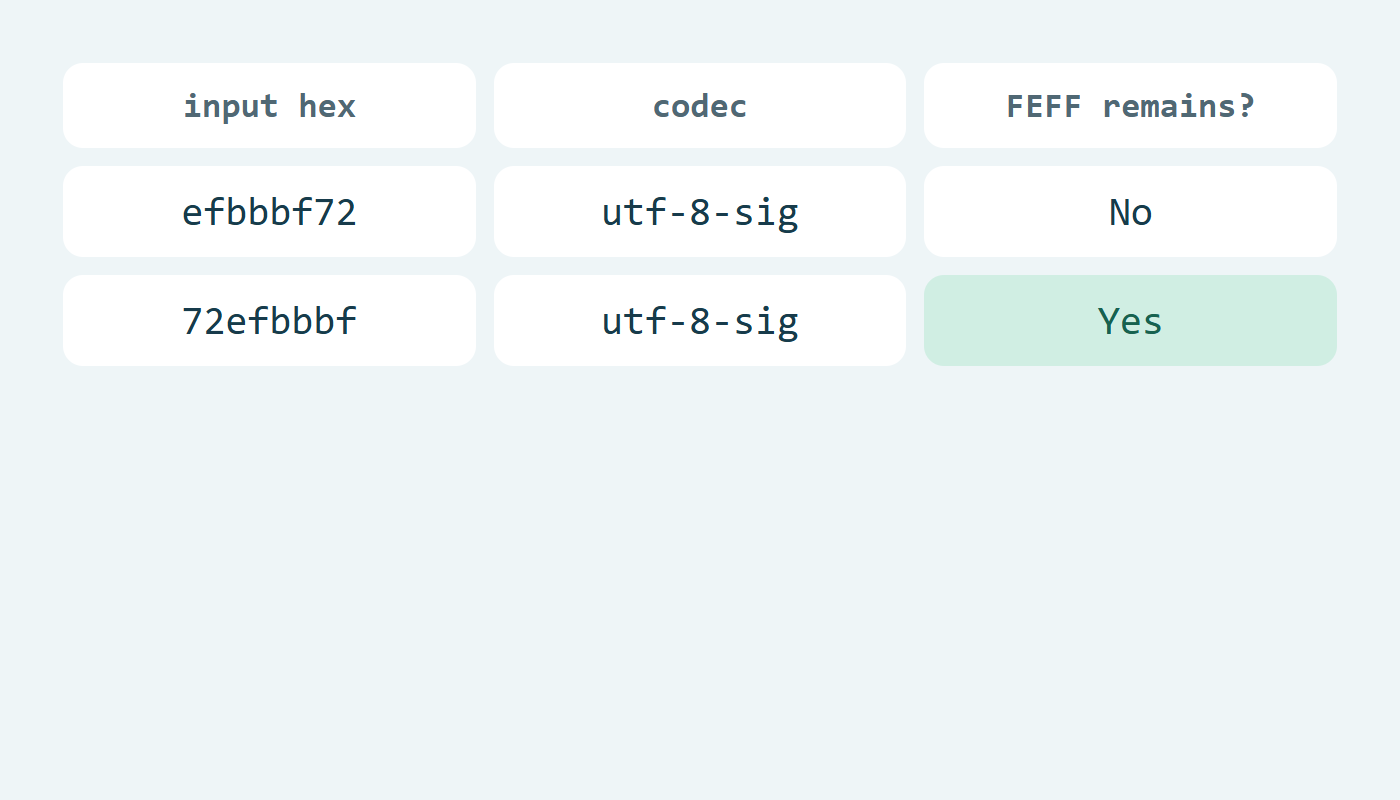
أما 72 وحده فيعطي r، وطوله واحد مع الخيارين؛ التوقيع اختياري عند القراءة. [1] [2]
النطاق
هذا فك بيانات كاملة؛ لم نختبر قراءة مجزأة أو كشف ترميز مجهول أو برنامج استقبال. [1] [2]
نستعمل الترميز المعروف للمصدر. [1] [2]
المراجع
- Python: codecs / utf_8_sig
- CPython 3.12.14: utf_8_sig.py
- موضوع تك: لغة بايثون — مفردات
- موضوع تك: تطبيقات بايثون — مفردات
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.