
بقاء الرموز لا يثبت بقاء التنسيق. [1] [2]
الخلاصة السريعة
ضمان untokenize يخص نوع الرمز ونصه؛ قد تتغير المسافات. [1] [2]
المثال
import io,tokenize as t
s='x  =  4\n'
r=io.StringIO(s).readline
ts=t.generate_tokens(r)
pairs=((z.type,z.string) for z in ts)
out=t.untokenize(pairs)
print(out==s)
print(repr(out))
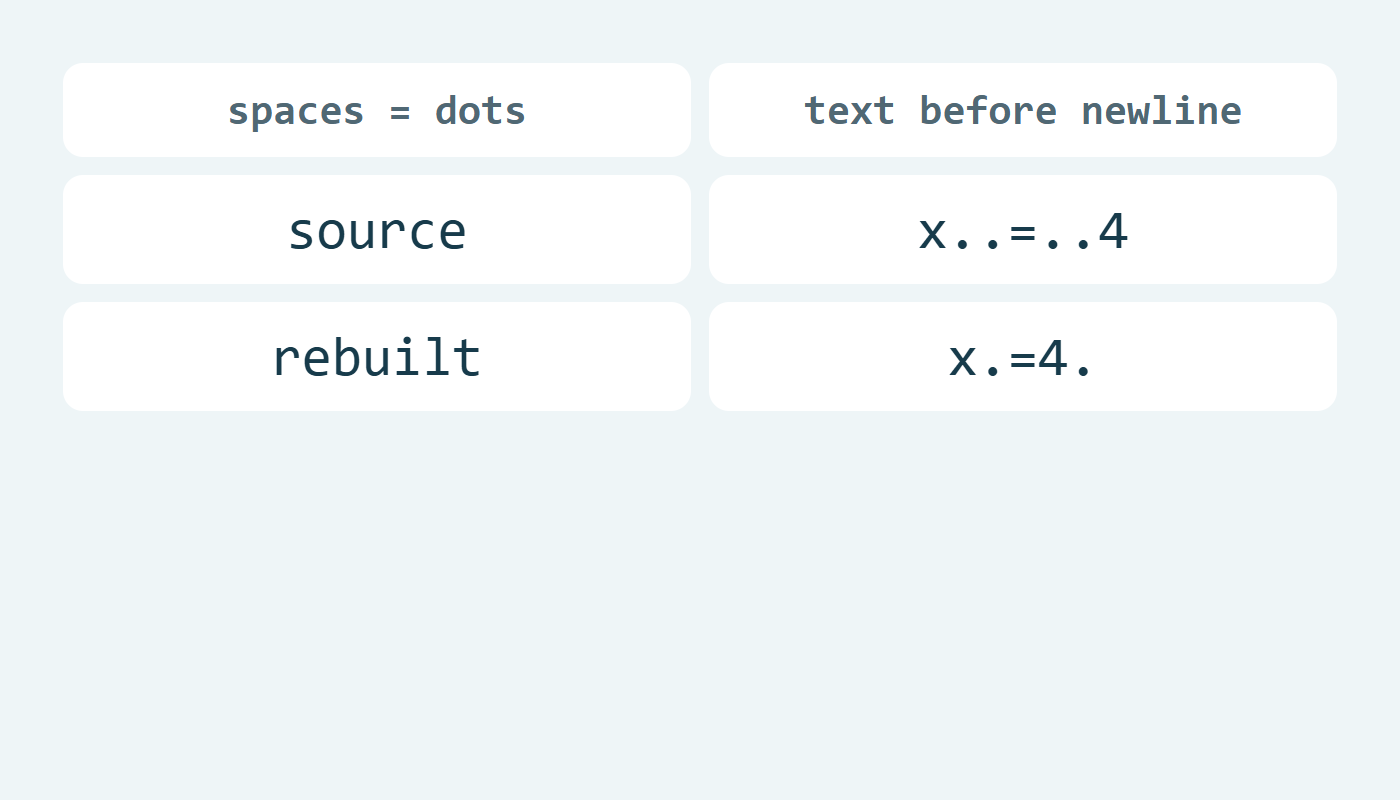
المخرجات: False ثم 'x =4 \n'. [1] [2]
ما الذي بقي؟
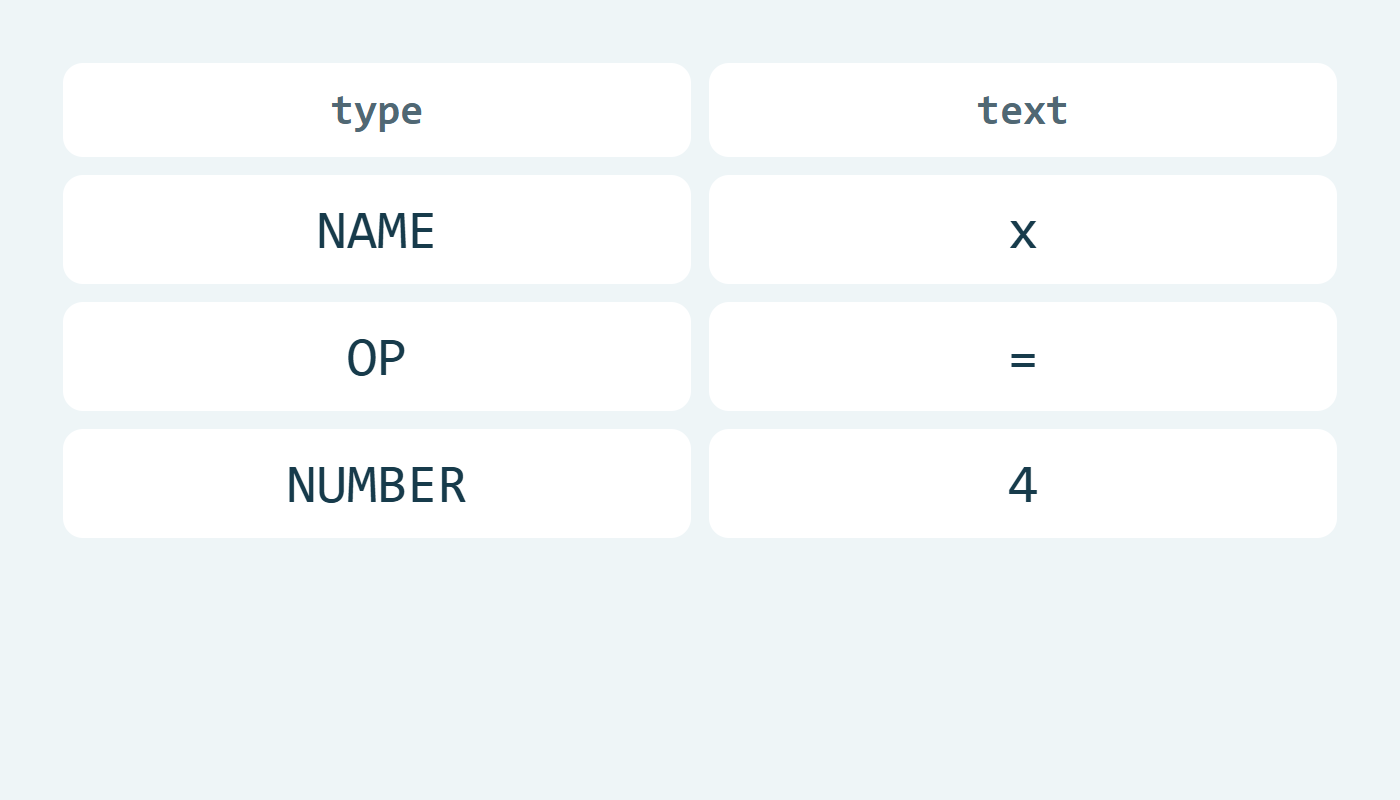
في مسار الزوجين، يضيف التنفيذ مسافة بعد الاسم والعدد. [1] [2]
بعد إعادة البناء يبقى تسلسل الأنواع والنصوص؛ مواضع الأعمدة ليست الضمان. [1] [2]
النطاق
نعرض سلسلة نصية بلا رمز ترميز، ونستخدم repr لإظهار نهاية السطر والمسافة الأخيرة. [1] [2]
المراجع
- Python: tokenize
- CPython 3.12.14: tokenize.py
- موضوع تك: لغة بايثون — مفردات
- موضوع تك: تطبيقات بايثون — مفردات
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.